

Guide pratique : économiser ses tokens - Les réflexes pour tous
Chez aqoba, on utilise l'IA au quotidien, en mission comme pour notre propre travail, et la question de la consommation de tokens revient sans cesse. Ce guide rassemble les bonnes pratiques qu'on a pu observer et appliquer. Les sources sont citées en fin d'article.
Pourquoi s'en soucier ?
- Le coût : on paie tout ce qu'on envoie et tout ce que le modèle répond. Les prix montent, et les nouveaux tokenizers produisent plus de tokens pour le même texte.
- Les quotas : moins de tokens, c'est moins de « limite atteinte, revenez dans 3 h ».
- La qualité : plus la conversation est chargée, plus le modèle hallucine. Économiser des tokens améliore les réponses.
- L'environnement : moins de tokens, c'est moins de calcul et moins d'énergie.
- La vitesse : moins de tokens, c'est moins d'attente.
Le principe à retenir : à chaque message, le modèle relit toute la conversation depuis le début, plus toutes ses instructions. Le vrai coût n'est pas votre question, c'est tout ce qui l'accompagne.
Ne visez pas « moins de tokens » pour lui-même (loi de Goodhart) : l'objectif est le même résultat (ou meilleur) pour moins de tokens. Et si votre organisation mesure l'adoption de l'IA au volume de tokens consommés, alertez-la : c'est une métrique qui se truque facilement.
Comprendre ce qu'on paie
Mieux vaut commencer par là plutôt que par des astuces : quand on sait comment le modèle travaille, on retrouve seul la plupart des réflexes de ce guide.
- Le modèle ne lit pas du texte mais des tokens (un mot, un morceau de mot ou un signe de ponctuation), convertis en nombres puis en vecteurs qui les placent dans un espace de sens.
- Il écrit un token à la fois, et relit pour chacun votre demande et tout ce qu'il a déjà écrit. C'est l'origine du principe ci-dessus.
- Écrire coûte environ 5 fois plus cher que lire, et la réflexion (thinking) est facturée comme de l'écriture (voir 2.8).
- Le fournisseur met en cache le début inchangé de la conversation, que le modèle relit alors pour environ 10 % du prix normal. Ce cache expire au bout de quelques minutes à une heure d'inactivité, selon les réglages : une conversation reprise après une longue pause est entièrement refacturée.
- Le modèle n'a pas de mémoire. Historique, mémoire, projets : tout vient de l'outil qui l'entoure (le harness), et tout est renvoyé à chaque message.
- Une hallucination n'est pas un mensonge : c'est la suite la plus probable compte tenu de ce que le modèle a lu. On la corrige en changeant ce qu'il lit (1.4), pas en répétant « c'est faux ».
Pour voir tout cela en images, une vidéo de 6 à 7 minutes, à montrer à tout le monde, tech ou non, est en lien en fin d'article.
L'essentiel en 10 réflexes
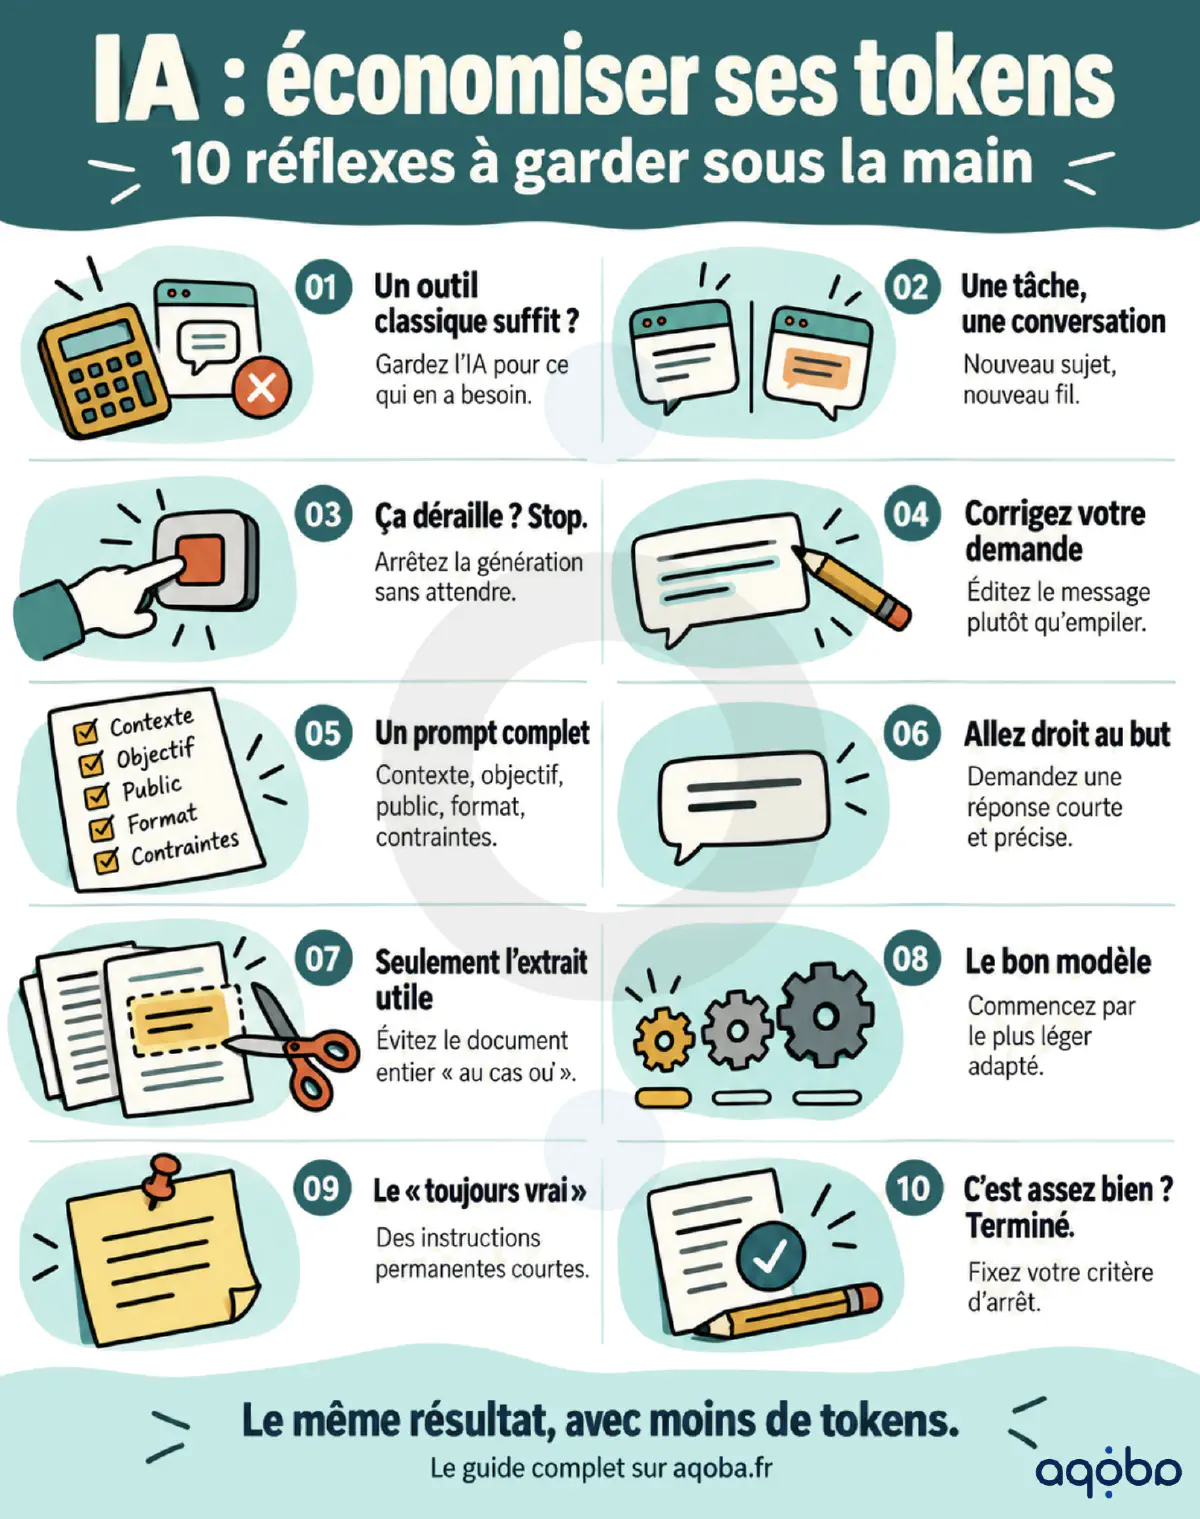
Le guide est organisé en deux niveaux : le premier concerne tout le monde, dès aujourd'hui ; le second s'adresse aux utilisateurs réguliers qui jonglent entre projets, modèles et quotas.
Niveau 1 - Les réflexes de base (tout le monde, tout outil)
1.1 Ne pas utiliser l'IA quand ce n'est pas nécessaire
Calcul, conversion de fichier, renommage, recherche dans un document, mise en forme : Excel, l'IDE, un outil de conversion ou un Ctrl+F le font gratuitement et sans erreur.
Exemple : exporter chaque sprint les tickets de Jira pour demander à l'IA combien sont bloqués, par équipe. Un filtre enregistré ou un tableau de bord Jira donne le même chiffre, à jour en permanence et sans rien recopier.
1.2 Arrêter la génération dès que ça déraille
Le texte est produit mot à mot. Si la réponse part dans le mauvais sens, cliquez Stop : chaque mot non généré est économisé.
1.3 Une tâche = une conversation
- Ouvrez une nouvelle conversation pour chaque nouveau sujet, plutôt qu'un fil unique qui dure toute la journée.
- Si le modèle s'embourbe après plusieurs tentatives, demandez-lui d'extraire l'essentiel du contexte et utilisez ça pour commencer une nouvelle conversation plutôt que de lui faire relire tous ses échecs.
- Si vraiment vous voulez rester dans la conversation, vous pouvez compacter le contexte (aide-mémoire en fin d'article) avec une guideline claire sur ce qu'il faut garder. Comme ça vous repartez sur un contexte plus propre.
- Pas de « merci ! » en fin de longue conversation : il renvoie tout l'historique pour obtenir un « de rien ».
1.4 Modifier son message plutôt qu'empiler les corrections
Dans ChatGPT, Claude ou Le Chat, vous pouvez éditer votre message précédent. La mauvaise réponse sort alors de l'historique, au lieu d'ajouter « non, pas comme ça... » par-dessus.
Ce conseil découle directement du fonctionnement du modèle : une réponse fausse est la suite la plus probable compte tenu de ce qu'il a lu. Lui répéter « c'est faux » l'oblige à relire son erreur et à repartir de là ; corriger le prompt change ce qu'il lit, donc ce qu'il produit.
1.5 Un bon prompt du premier coup
Chaque aller-retour de clarification renvoie toute la conversation. Donnez d'emblée :
- le contexte (qui je suis, la situation) ;
- l'objectif (ce que je veux obtenir) ;
- le public (pour qui) ;
- le format attendu (tableau, 5 puces, 1 paragraphe, un mail de 10 lignes...) ;
- les contraintes (ton, longueur, ce qu'il ne faut pas faire).
Le critiqueur de prompt aqoba. Avant d'envoyer un prompt important, faites-le relire. Nous avons écrit un skill qui vérifie que votre demande précise le contexte, l'objectif, le public, le format et les contraintes, signale ce qui manque et propose une version corrigée. Il vous conseille aussi le modèle (2.1) et le niveau d'effort (2.8) adaptés à la demande. Il est disponible dans notre boîte à outils IA sur GitHub.
Donner un rôle au modèle (« Tu es un product manager senior... ») n'a rien d'un rituel : ces mots orientent le modèle vers la zone de connaissances qui vous intéresse, et ses réponses sont plus justes.
Si vous n'avez pas ces informations, un prompt plus vague avec un niveau d'effort élevé peut vous aider à déterminer les informations nécessaires avant de vous lancer dans une tâche avec de mauvaises suppositions.
1.6 Un style direct, à l'impératif
- À privilégier : « Résume ce texte en 5 puces. »
- À éviter : « Bonjour, pourriez-vous s'il vous plaît, si ce n'est pas trop demander, me faire un résumé de ce texte ? Merci beaucoup ! »
1.7 Demander des réponses courtes et sans fioritures
Les « Excellente question ! », « Vous avez raison ! », les introductions, conclusions et « Veux-tu que je... » non demandés sont des tokens payés pour rien.
- Précisez la longueur et le format : « Sans introduction ni conclusion », « Réponds en 3 lignes max ». Cela raccourcit la réponse, pas la réflexion du modèle : pour celle-ci, voir 2.8.
- Mettez-le une fois pour toutes dans vos instructions personnalisées (voir 2.3). Par exemple :
« Réponds de façon concise et factuelle. Pas de compliments, pas de reformulation de ma question, pas de suggestions non demandées. Mon frigo ne me donne pas son avis sur la façon dont je range mes courses : fais ce que je demande, rien de plus. »
1.8 N'envoyer que ce qui est utile
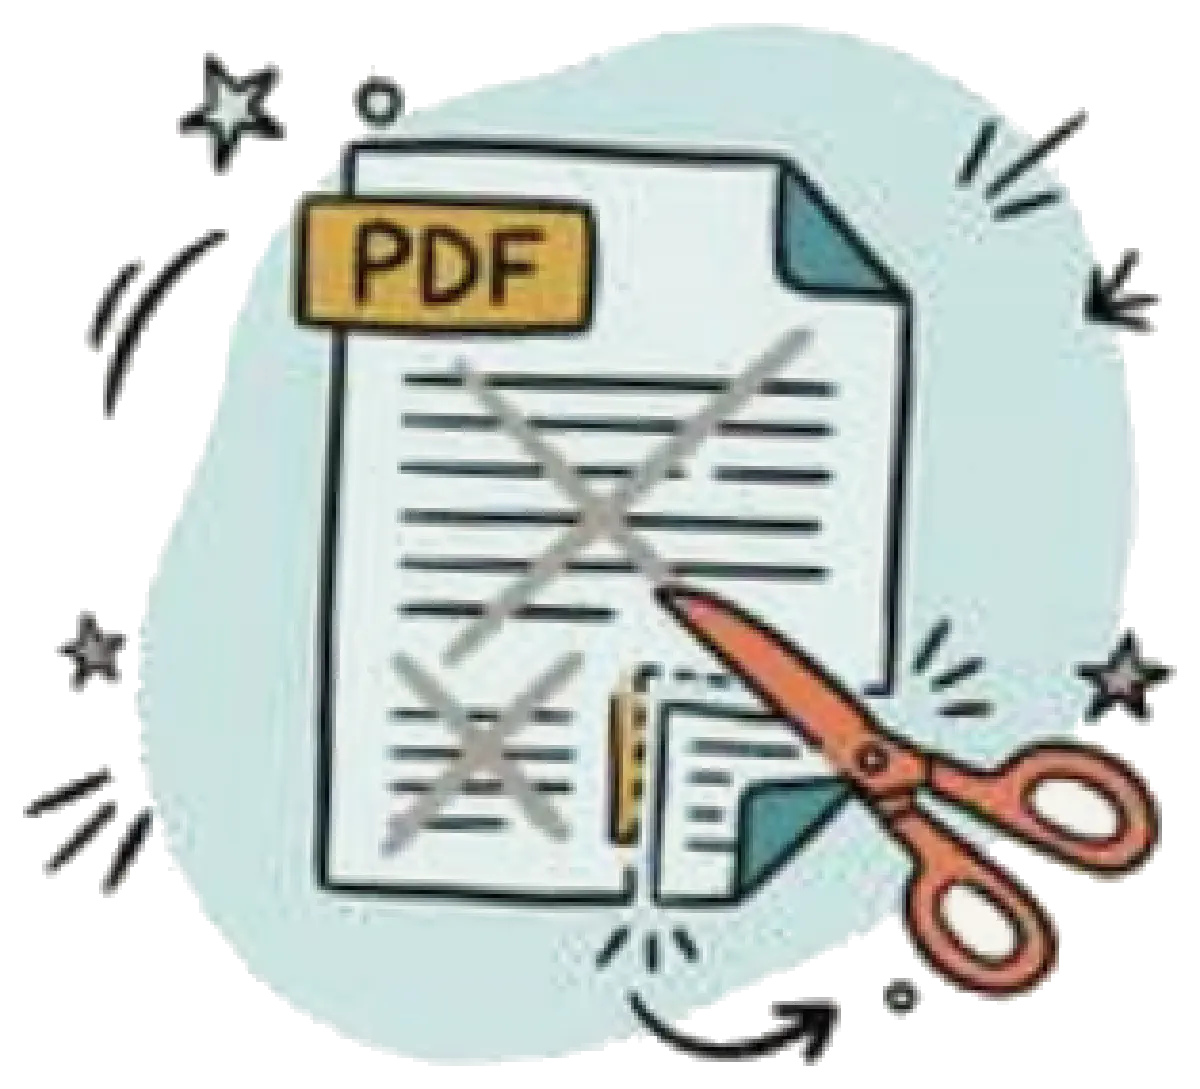
- PDF : c'est le format le plus cher (texte et image de chaque page). Copiez-collez le passage utile, convertissez en texte avant ou faites une capture d’écran qui restera moins chère.
- Images et captures d'écran : le coût dépend de la taille. Recadrez sur la zone utile, évitez les captures plein écran en 4K.
- Longs documents : n'envoyez que la section concernée, pas le document entier « au cas où ».
1.9 Rester dans sa langue
Le français coûte un peu plus de tokens que l'anglais, mais un prompt mal formulé dans une langue mal maîtrisée coûte beaucoup plus d'itérations. Écrivez dans la langue où vous êtes le plus précis.
1.10 « Le mieux est l'ennemi du bien »
L'IA trouvera toujours quelque chose à améliorer : un résumé peut être raccourci à l'infini, une revue trouvera toujours un détail. Fixez le critère d'arrêt (« signale uniquement les problèmes bloquants ») et arrêtez quand c'est assez bien.
Niveau 2 - Utilisateurs réguliers (projets, modèles, quotas)
2.1 Choisir le modèle adapté à la tâche
| Type de tâche | Modèle adapté | Exemples |
|---|---|---|
| Question simple, reformulation, tri, extraction | Léger (Haiku, GPT « mini », Mistral Small...) | Corriger un mail, extraire des dates, classer des verbatims |
| Rédaction, analyse, code courant | Intermédiaire (Sonnet, GPT standard...) | Rédiger un support, analyser un CR, écrire un script |
| Raisonnement complexe, architecture, stratégie | Haut de gamme (Opus, modèles « raisonnement ») | Concevoir une architecture, arbitrer un problème complexe |
- Commencer par le moins cher, puis monter : si vous ne savez pas quel modèle choisir, essayez d'abord le léger. Si le résultat ne convient pas, vous avez perdu quelques centimes et vous passez au niveau au-dessus. À terme, vous saurez intuitivement quelles sont les capacités de chaque modèle. Si vous avez l'habitude d'utiliser Opus / Sol depuis un moment, vous serez surpris par la qualité des réponses de Sonnet / Luna. Un ordre de grandeur : 1,20 € avec Sonnet pour une tâche qui aurait coûté 5 à 7 € en partant directement sur Opus.
- Concevoir avec le gros, exécuter avec le petit : le modèle haut de gamme produit le plan et le format attendu, un modèle léger ou intermédiaire l'exécute (voir 2.7).
- Se calibrer : faites passer quelques tâches typiques sur les trois niveaux et comparez le résultat. Après quelques essais, vous savez quelle famille de tâches va avec quel modèle.
- Se faire conseiller : le critiqueur de prompt aqoba (point 1.5) propose un modèle pour chaque demande, ce qui évite de partir par défaut sur le plus cher.
- La fausse économie : un petit modèle sur une tâche complexe, c'est plus d'itérations, donc au final plus cher.
- Le mode « auto » (GitHub Copilot) : l'outil choisit le modèle à votre place, un bon choix par défaut quand on ne sait pas lequel prendre. Depuis juin 2026, Copilot facture au token, au tarif de chaque modèle.
- Faites une veille régulière : les modèles et leurs prix changent tous les mois. Regardez le coût à la tâche, pas seulement le prix au token : Opus 5.5, par exemple, fait la même tâche qu'Opus 5 avec moins de tokens.
Pour fixer les ordres de grandeur, les prix de l'API Anthropic en octobre 2026, en dollars par million de tokens :
| Modèle | Entrée | Sortie |
|---|---|---|
| Haiku 5.5 | 0,10 | 0,50 |
| Sonnet 5.5 | 2 | 10 |
| Opus 5.5 | 4 | 20 |
| Fable 5.1 | 10 | 50 |
Entre Haiku et Sonnet, l'écart est de 1 à 20. Attention, le prix d'Haiku 5.5 est multiplié par 5 quand le prompt dépasse 100 000 tokens : un petit modèle n'est bon marché que sur des contextes courts.
2.2 Gérer les quotas glissants
Les quotas des abonnements fonctionnent souvent en fenêtre glissante (ex. 5 h à partir du premier message), pas en reset à heure fixe.
- L'astuce « bonjour au réveil » : un premier message depuis son téléphone le matin démarre la fenêtre. Elle se renouvelle plus tôt dans la journée de travail. Vous pouvez créer une routine Claude depuis cette page.
- C'est de l'optimisation de quota, pas de la sobriété. Ne vous réveillez pas à 5 h pour ça (des gens l’ont fait).
- Quand le mur arrive : attendre, changer de modèle, passer sur un modèle local... ou appliquer ce guide.
2.3 Des instructions permanentes courtes : seulement le « toujours vrai »
Instructions personnalisées (ChatGPT), instructions de projet (Claude, ChatGPT), AGENTS.md / CLAUDE.md / copilot-instructions.md (outils de code) : tout ce contenu est renvoyé à chaque message.
- À y mettre : ce qui est toujours vrai, qui je suis, mon style attendu, le format de réponse par défaut.
- À ne pas y mettre : le conditionnel (« dans le cas où je fais un atelier, alors... »), à placer dans un document ou un skill chargé seulement si besoin.
- Ni ce que le modèle sait déjà ou voit par lui-même, ni des consignes qui se contredisent (« documente quand c'est utile » d'un côté, « pas de commentaires » de l'autre). Retirez aussi les « réfléchis bien » : sans eux, Opus 5.5 répond plus vite, sans perte nette de qualité selon Anthropic.
- Ordre de grandeur : 5 000 tokens d'instructions × 200 messages = 1 million de tokens.
- Anthropic a retiré plus de 80 % du prompt système de Claude Code pour ses derniers modèles, sans perte mesurable sur ses évaluations.
2.4 Utiliser les projets pour ne pas tout recoller
Plutôt que de recoller le même contexte dans chaque conversation, créez un projet (Claude, ChatGPT) avec les documents de référence de votre sujet. Gardez-le léger : un document de synthèse vaut mieux que 15 PDF bruts.
2.5 Partager l'intention, pas tout le corpus
Le modèle ne peut pas deviner ce qui n'est écrit nulle part. Plutôt que de lui donner toute la documentation en espérant qu'il comprenne, donnez-lui l'intention humaine : ce qui s'est dit en atelier, en rituel, en interview, les décisions et leurs raisons. Moins de volume, plus de pertinence.
2.6 Le prompt de passation
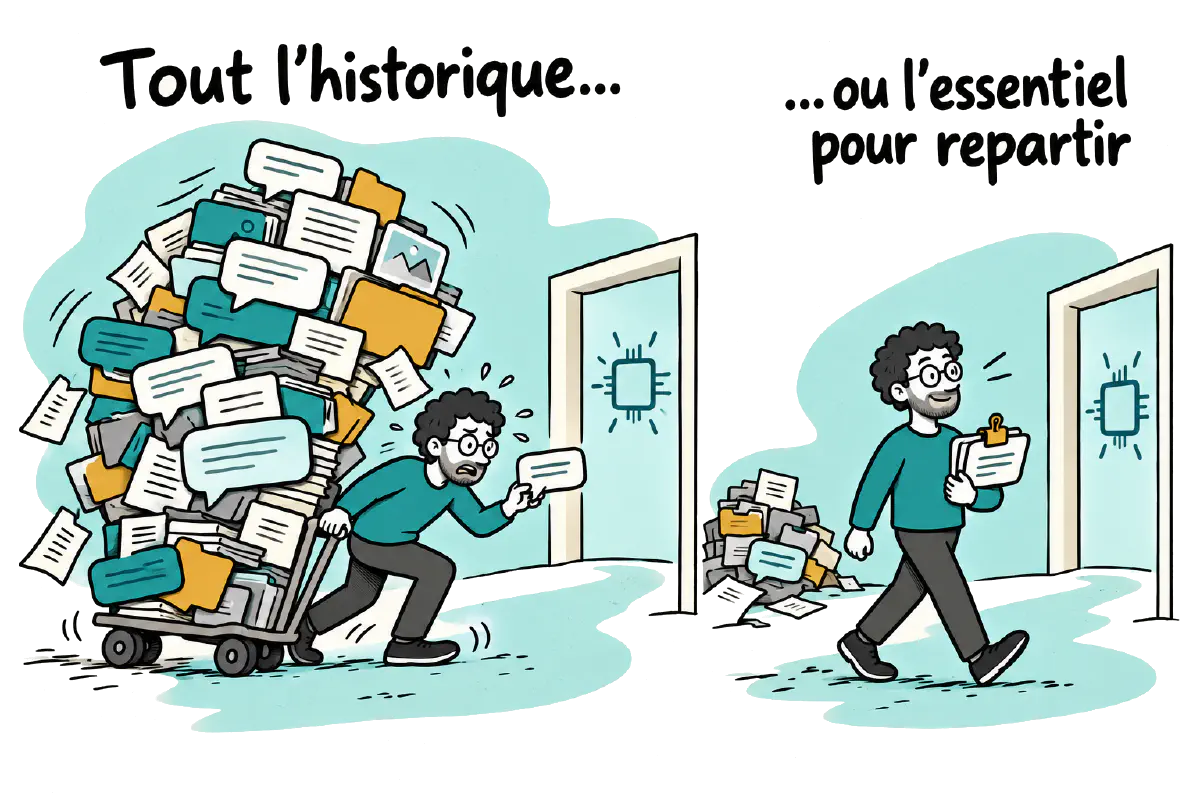
Après une longue phase de réflexion dans une conversation :
- Demandez « Rédige le prompt complet qui permettrait de réaliser ce qu'on a décidé, dans une nouvelle conversation. »
- Relisez-le et complétez-le si besoin : tout résumé perd des détails.
- Ouvrez une nouvelle conversation et collez-y ce prompt.
On garde les décisions, sans traîner tous les tâtonnements, et le modèle hallucine moins.
En fin de journée : avant d'arrêter une longue session, faites écrire le prompt de reprise du lendemain (contexte, décisions, prochaines étapes). Quentin Roussel, Senior PM chez Trainline, estime recharger ainsi environ 80 % de tokens en moins le lendemain qu'en rouvrant la conversation, dont le cache aura expiré entre-temps. Il en a fait un skill de handoff.
2.7 Planifier avant d'exécuter
Pour une tâche conséquente, commencez par faire produire un plan (objectif, étapes, contraintes, livrables), validez-le, puis lancez la réalisation. Les intervenants de Zenika ont mesuré -10 % de tokens, et le plan est réutilisable pour une tâche similaire.
- Dans les outils de code : le mode plan (Claude Code, Copilot, Cursor).
- En chat : « Avant de rédiger, propose-moi un plan en 5 étapes. Attends ma validation. »
2.8 Régler le niveau d'effort selon la tâche
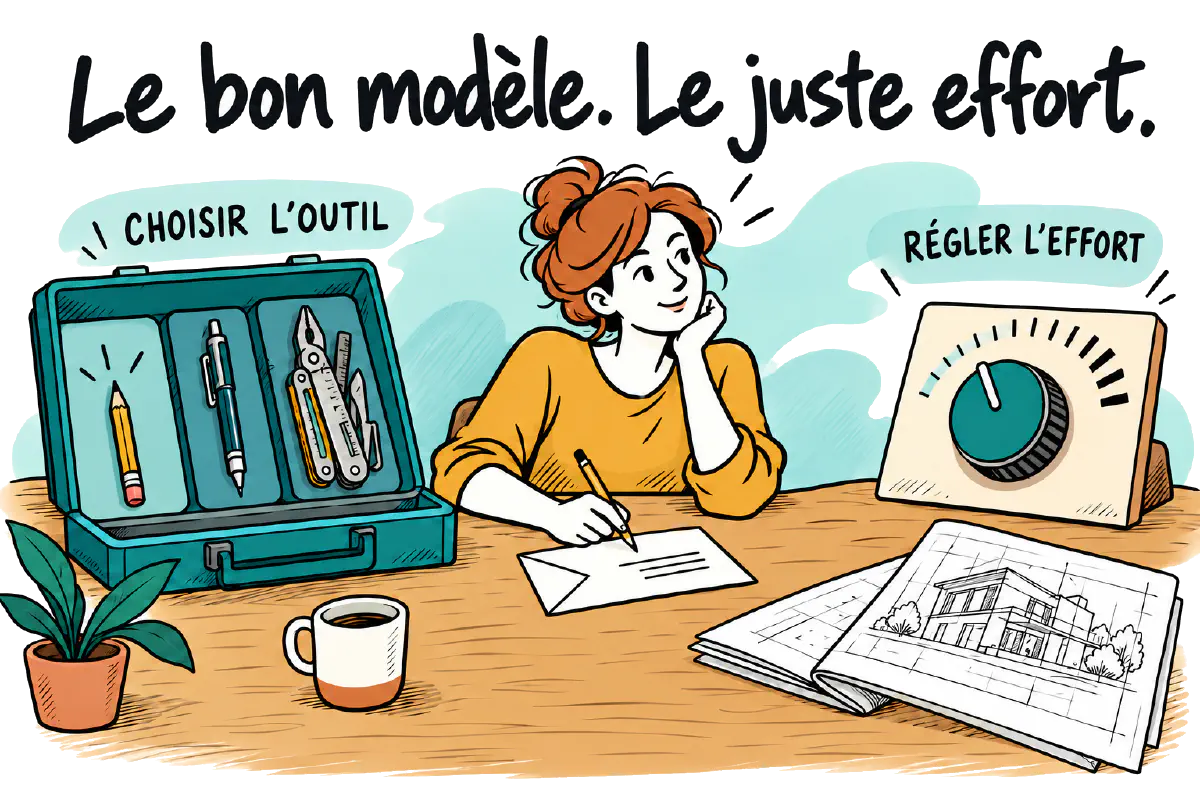
Les modes « réflexion » / « thinking » consomment beaucoup de tokens invisibles. Sur les derniers modèles Claude, la réflexion ne se coupe plus : elle se règle avec le niveau d'effort : faible, moyen, élevé, très élevé (xhigh) et max, par exemple avec la commande /effort dans Claude Code. La qualité de la réponse dépend surtout du modèle choisi (2.1) ; l'effort fixe la quantité de travail que Claude fournit avant de revenir vers vous, c'est-à-dire combien de fichiers il lit, combien il vérifie et jusqu'où il avance seul. À effort faible, il préfère vous poser une question plutôt que de dépenser des tokens à chercher ; à effort élevé, il vérifie davantage, mais il prend aussi plus de décisions à votre place.
Quel niveau choisir :
- Faible quand vous voulez rester dans la boucle et itérer (brainstorm, premier jet, reformulation), pour une tâche simple, ou pour retoucher une version déjà réussie à un niveau plus élevé. Thariq Shihipar, de l'équipe Claude Code, a obtenu la même idée de refonte d'un menu en 1 minute en effort faible et en 28 minutes en max : la version max était plus soignée, mais pour donner son avis et itérer, la version rapide suffisait. À ce niveau, Claude fait ce qu'on lui demande et rien de plus, donc listez les étapes quand la demande en comporte plusieurs.
- Moyen pour le travail courant. Anthropic conseille de garder le niveau par défaut du modèle pour la plupart des tâches, et d'en changer selon le type de travail qu'on fait plutôt qu'à chaque demande. Si vous aviez réglé l'effort sur un ancien modèle, repartez du réglage par défaut : les niveaux ne se comparent pas d'un modèle à l'autre, et Opus 5.5 en moyen fait aussi bien qu'Opus 5 en élevé.
- Élevé quand une erreur passée inaperçue coûterait cher ou que la tâche cache beaucoup de cas particuliers : rapprocher des chiffres de plusieurs sources, relire un contrat, vérifier un long document. Dans un test d'Anthropic sur une analyse de données, Claude en effort faible préparait les données d'une seule façon et se trompait à chaque essai ; en effort élevé, il essayait deux préparations, remarquait que les résultats divergeaient, cherchait pourquoi et réussissait 4 fois sur 5.
- Très élevé et max seulement pour une tâche longue, difficile et critique que vous laissez tourner sans intervenir. Commencez par très élevé, moins cher que max.
En cas de doute, le critiqueur de prompt aqoba (1.5) suggère un niveau d'effort pour chaque demande.
Faire en faible, vérifier en élevé. Thariq Shihipar travaille ainsi : il se fait interviewer par Claude pour compléter sa demande, fait réaliser le travail en effort faible, relit et corrige toujours en effort faible, puis passe en effort élevé pour la vérification finale. L'effort élevé n'est payé que pour vérifier, et dans Claude Code, changer de niveau en cours de conversation ne casse pas le cache sur les modèles récents.
Si le résultat déçoit, ne montez pas l'effort tout de suite. Revoyez d'abord le prompt et le contexte (1.5). Ensuite, demandez-vous si Claude n'a pas assez cherché ou s'il ne savait pas : s'il a sauté une étape ou n'a pas vérifié son travail, montez l'effort ; s'il avait tout le contexte, a manifestement essayé et s'est quand même trompé, passez à un modèle plus capable (2.1).
- Les tokens de réflexion sont facturés au prix de la sortie, environ 5 fois celui de l'entrée, et ils s'accumulent vite : sur des tests de développement publiés par Anthropic, Fable 5.1 consommait en médiane 73 000 tokens par essai en effort faible, contre 222 000 en max. Le niveau maximal sur le modèle le plus cher pour écrire un mail cumule donc les deux surcoûts.
- Pour que le modèle réfléchisse moins, baissez l'effort plutôt que de l'écrire dans le prompt (« réponds sans réfléchir ») : selon Anthropic, c'est ce qui réduit le plus sûrement la réflexion, et avec elle le coût et l'attente.
- Plus d'effort ne donne pas toujours un meilleur résultat. En mode max, les gros modèles raisonnent parfois longuement sur chaque détail du prompt, pour une réponse moins bonne, plus lente et plus chère, et Anthropic surveille ce surraisonnement pendant l'entraînement de ses modèles parce qu'il dégrade les résultats. Sur les petits modèles, la réflexion peut aussi mener à l'erreur quand les informations données se contredisent.
- Certaines entreprises règlent tout le monde par défaut sur Sonnet en effort moyen.
Aide-mémoire par outil
| Besoin | ChatGPT | Claude (web/desktop) | Claude Code | GitHub Copilot |
|---|---|---|---|---|
| Repartir de zéro | Nouvelle conversation | Nouvelle conversation | /clear | Nouvelle session de chat |
| Résumer la session | Prompt de passation ou /compact | Prompt de passation | /compact | Automatique |
| Voir le contexte consommé | /compact | /context (desktop) | /context, status line | - |
| Voir le coût de la session | - | - | /usage, status line | - |
| Instructions permanentes | Instructions personnalisées, projets | Instructions de projet, styles | CLAUDE.md / AGENTS.md | copilot-instructions.md / AGENTS.md |
| Changer de modèle | Sélecteur de modèle | Sélecteur de modèle | /model | Sélecteur (dont « Auto ») |
| Consulter un modèle plus fort | - | - | /advisor | - |
| Planifier d'abord | Le demander dans le prompt | Le demander dans le prompt | Mode plan, opusplan | Mode plan / agent |
Les fonctionnalités évoluent vite : vérifiez dans votre version.
Dans le second article, on s’adressera aux utilisateurs avancés : agents de code, skills, MCP, cache, LLM locaux et routage entre modèles.
Références
Ce guide s'appuie surtout sur les deux interventions citées en tête de liste, complétées par des articles d'Anthropic et par nos propres pratiques.
- Norbert Jeff Nadir et Christophe Breheret-Girardin (Zenika), « Save the tokens, save the world », talk à Agile en Seine 2026 (1.1, 1.5, 1.7, 2.6, 2.7).
- Quentin Roussel (Trainline), « Token Optimisation : maîtriser son budget IA », meetup en ligne organisé par TPC, 27 octobre 2026 (« Comprendre ce qu'on paie », 1.4, 2.1, 2.6, 2.8).
- Vidéo de présentation du fonctionnement d'un LLM: tokenisation, embeddings (« Comprendre ce qu'on paie »).
- Anthropic :
- Grille tarifaire de l'API, consultée en octobre 2026 (2.1).
- Documentation du prompt caching (durée et coût du cache ; « Comprendre ce qu'on paie », 2.6).
- Thariq Shihipar, « Using Claude Code: Spending your effort », blog claude.dev, 25 septembre 2026 (2.8).
- Lydia Hallie, « Choosing a Claude model and effort level in Claude Code », claude.com, 7 juillet 2026 (2.8).
- Thariq Shihipar, « The new rules of context engineering for Claude 5 generation models », blog claude.dev, 24 juillet 2026.
- « Prompting Claude Opus 5.5 », documentation Claude Platform, consultée en octobre 2026.
- Diane Sarkis, « Building agents: When to fold subagents into your main agent loop », claude.com, 22 octobre 2026.
- Loi de Goodhart, Wikipédia (« Pourquoi s'en soucier ? »).
- aqoba, « Critiqueur de prompt », skill, dans la boîte à outils IA d'aqoba sur GitHub (1.5).